
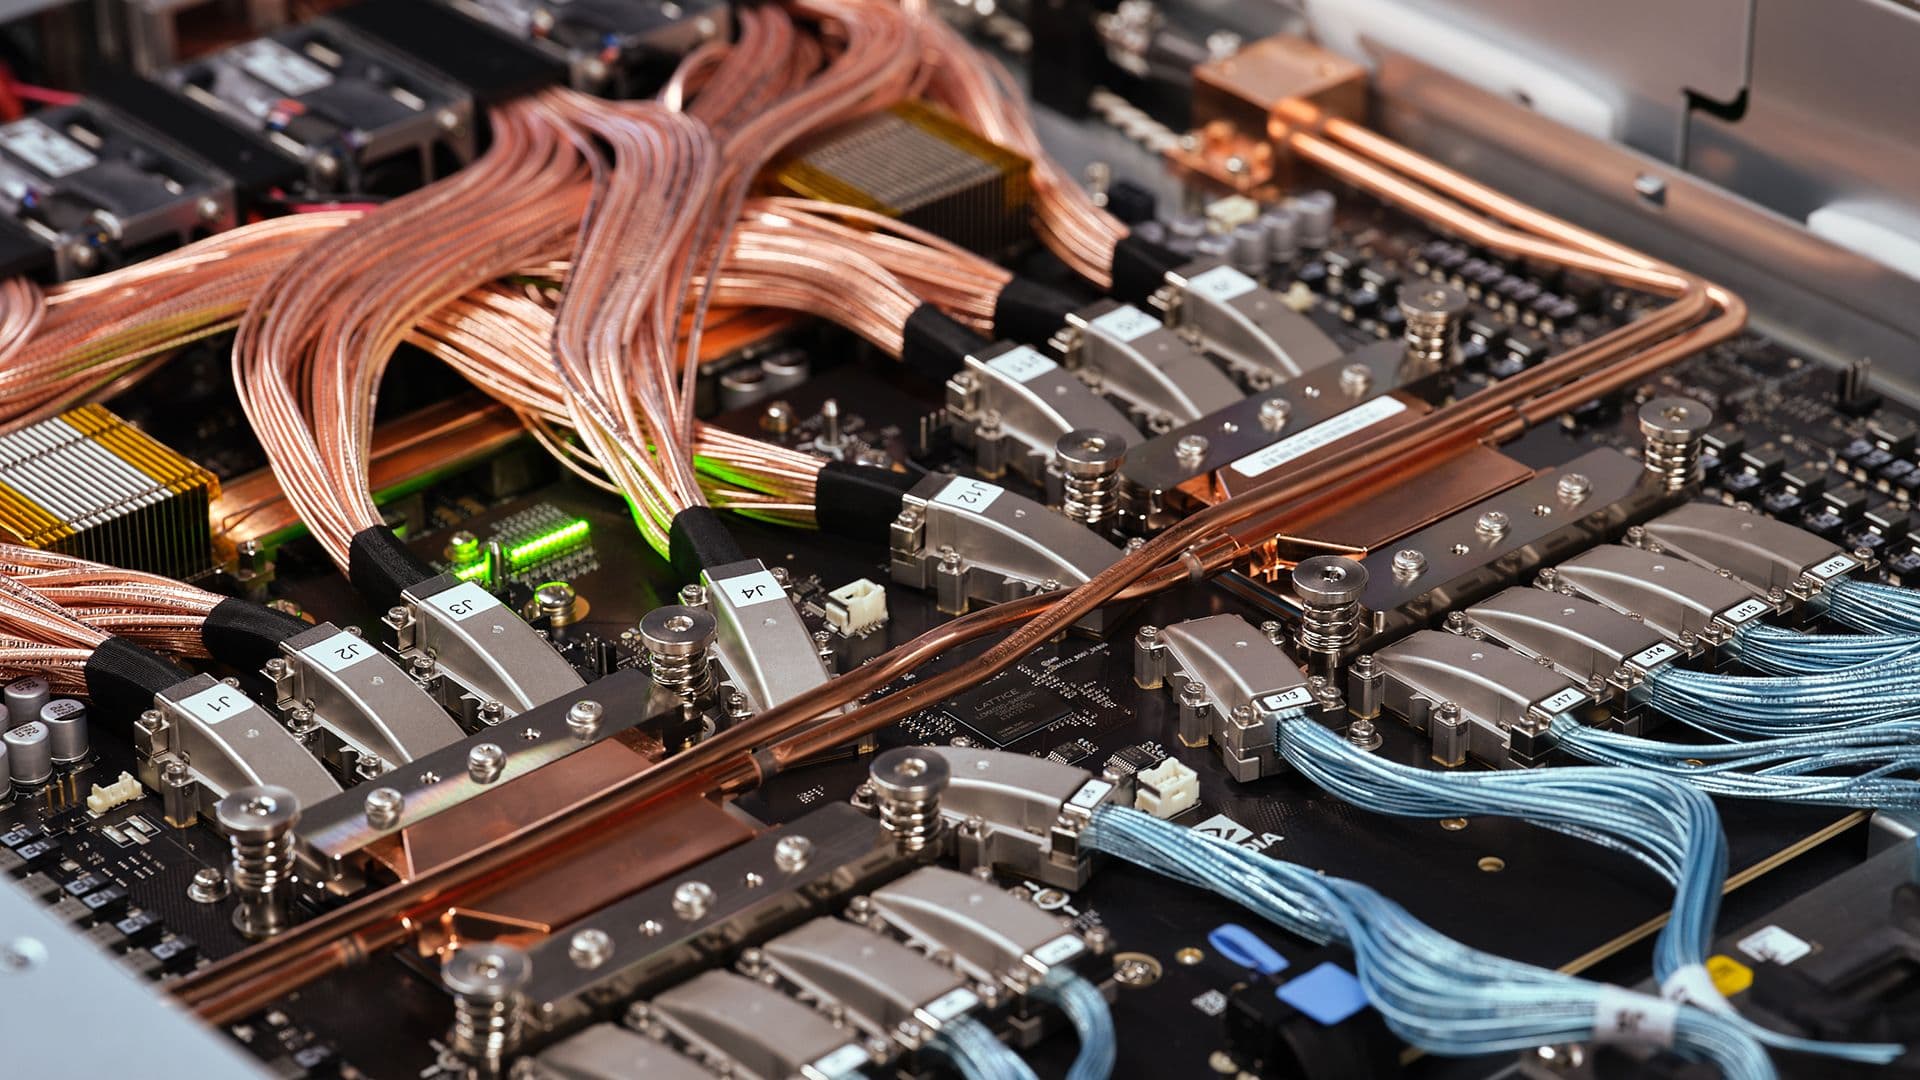
بر اساس گزارش اطلاعات (The Information)، شرکت اپل (Apple) ظاهراً در حال توسعه سرورهای هوش مصنوعی بر اساس پردازندههای سری M خود است و فناوری NVLink Fusion را برای اتصالهای داخلی ارزیابی میکند. این گزارش مدعی است که این ماشینها از پردازندههای M8 اولترا (M8 Ultra) استفاده خواهند کرد و در سال ۲۰۲۹ از راه خواهند رسید. در حال حاضر، استفاده از پلتفرم NVLink Fusion رسمی نشده و توسط هیچکدام از شرکتهای اپل (Apple) یا انویدیا (Nvidia) تایید نشده است، اما اگر اپل تصمیم بگیرد به جای راهحلهای رقیب از آن استفاده کند، این امر ممکن است پیامدهای بازاری بسیار گستردهتری نسبت صرفاً استفاده اپل از سختافزار انویدیا داشته باشد.
اپل به دنبال اتصالهای سریع
بر اساس گزارشها، اپل حداقل در حال بررسی دو پیکربندی سرور است: یک دستگاه کوچکتر مجهز به دو پردازنده M8 اولترا (M8 Ultra) و یک نسخه ردهبالاتر که دارای چهار تراشه M8 اولترا (M8 Ultra) است. اگرچه اپل فناوری UltraFusion خودش را برای اتصال یکپارچه دو تراشه ردهبالا به یکدیگر دارد، به نظر میرسد این شرکت راهحل مناسبی برای اتصال مقیاسپذیر پردازندههای خود ندارد و اینجاست که فناوری NVLink Fusion انویدیا وارد عمل میشود. ظاهراً اپل میخواهد از زیرساخت NVLink که شامل نه تنها یک پروتکل اتصال، بلکه سوییچها، تراشههایی که اتصال NVLink را اضافه میکنند و یک پشته نرمافزاری است، برای سرورهای خود استفاده کند. این پروژه ظاهراً حدود یک سال پیش آغاز شد و توسط جان ترنوس (John Ternus) زمانی که ریاست سازمان مهندسی سختافزار اپل را بر عهده داشت، پشتیبانی شد.
گزارش اطلاعات (The Information) حاکی از آن است که اپل هماکنون سرورهای سفارشی برای محاسبات ابری خصوصی (Private Cloud Compute) میسازد که بارهای کاری هوش مصنوعی را که برای اجرای محلی روی آیفونها و مکها بسیار سنگین هستند، مدیریت میکنند. بیشتر این ماشینها از فناوریهای اتصال توسعهیافته داخلی اپل استفاده میکنند که ظاهراً برای استقرار تجاری در مقیاس بزرگ بسیار کند و پرهزینه هستند، و به همین دلیل است که اپل به دنبال گزینههای دیگری است.
فراتر از NVLink؟
نشریه اطلاعات (The Information) بهطور خاص به نیاز اپل به فناوری اتصال مناسب برای استپرارهای در مقیاس بزرگ اشاره میکند، اگرچه توضیح نمیدهد که این از نظر معماری دقیقا به چه معناست. اگر این نشریه به اتصال چندین سرور به خوشههای بزرگتر اشاره دارد، این کار بهطور معمول وظیفه فناوریهای مقیاسپذیر افقی مانند اترنت (Ethernet) یا اینفینیبند (InfiniBand) است، نه یک ساختار مقیاسپذیر عمودی مانند NVLink. انویدیا در ابتدا فناوری ساختار NVLink خود را برای مقیاسپذیر کردن عملکرد شتابدهندههای خود توسعه داد، بنابراین این فناوری برای اتصال شتابدهنده به شتابدهنده بهینهسازی شده است و یک رک از واحدهای پردازش گرافیکی انویدیا (Nvidia) را قادر میسازد تا به عنوان یک دامنه محاسباتی بههمپیوسته عمل کند. پیادهسازی متفاوتی به نام NVLink-C2C وجود دارد که یک رابط تراشه به تراشه منسجم برای اتصال پردازندههای مرکزی به شتابدهندهها و پردازندههای مرکزی به یکدیگر است.
در همین حال، پردازندههای مدرن اپل ام پرو (Apple M Pro) و ام اولترا (M Ultra) بستههای سیستمی هستند که از یک تراشه پردازنده مرکزی و یک تراشه پردازنده گرافیکی/موتور عصبی تشکیل شدهاند که با استفاده از فناوری SoIC-mH شرکت تیاسامسی (TSMC) به یکدیگر دوخته شدهاند. اگر اپل به استفاده از این معماری ادامه دهد (که بسیار محتمل است)، یک پردازنده M8 اولترا (M8 Ultra) را میتوان به عنوان یک پردازنده مرکزی و یک شتابدهنده در نظر گرفت. با این حال، این سوال پیش میآید که اپل چگونه قصد دارد پردازندههای M8 اولترا (M8 Ultra) را به NVLink متصل کند و کدام اجزای این بسته سیستمی در دامنه NVLink شرکت خواهند کرد. یک احتمال این است که اپل میتواند بخش شتابدهنده M8 اولترا (M8 Ultra) را از طریق یک تراشه NVLink Fusion در معرض NVLink قرار دهد، که عملاً به این معنی است که آن را به عنوان یک شتابدهنده برای یک دامنه مقیاسپذیر در نظر خواهد گرفت. احتمال دیگر این است که اپل در حال توسعه معماری شتابدهنده متفاوتی برای سرورهای خود است، شاید با قرار دادن ساده تراشه پردازنده گرافیکی/واحد پردازش عصبی روی یک بستر/اینترپوزر جداگانه و تجهیز آن به حافظه خودش، اگرچه در حال حاضر هیچ مدرکی وجود ندارد که چنین طراحی را برای تراشهای که سالها با آن فاصله داریم، تایید کند.
نکته دیگری که باید در نظر داشته باشید این است که اپل عضو کنسرسیوم UALink است، سازمانی که بر توسعه اتصالهای استاندارد صنعتی شتابدهنده به شتابدهنده UALink که از حداکثر ۱۰۲۴ شتابدهنده پشتیبانی میکند، نظارت دارد. در حالی که در حال حاضر انتخاب محدودی از سوییچهای UALink وجود دارد، تا سال ۲۰۲۹ سوییچهای استاندارد صنعتی وجود خواهند داشت که عملکرد و قابلیتهای متفاوتی را ارائه میدهند، که انتخاب NVLink را به عنوان یک ساختار مقیاسپذیر حتی عجیبتر میکند.
یک توضیح احتمالی این است که اپل بسیار بیشتر از خود NVLink علاقهمند است. فناوری NVLink Fusion بخشی از معماری زیرساخت رکمقیاس و مرکز داده انویدیا (Nvidia) است که میتواند اتصال مقیاسپذیر NVLink را با شبکههای مقیاسپذیر افقی Spectrum-X Ethernet یا Quantum-X InfiniBand انویدیا، از جمله سوییچهای مجهز به اپتیک بستهبندیشده مشترک، ترکیب کند. بنابراین، اپل میتواند به طور بالقوه فناوری انویدیا را برای اتصال مقیاسپذیر عمودی و افقی به جای توسعه کل پشته شبکه مرکز داده خود اتخاذ کند. این در حال حاضر صرفاً حدس و گمان است، اما چنین رویکردی عملاً به این معنا خواهد بود که اپل در حال ساخت سرورهای هوش مصنوعی در اطراف بخشهای قابل توجهی از معماری مرکز داده انویدیا است، در حالی که پردازندههای خود را حفظ کرده و از شتابدهندههای انویدیا استفاده نمیکند. اگر این اتفاق بیافتد، این گواهی خواهد بود که انویدیا اکنون استانداردهای واقعی را برای مراکز داده هوش مصنوعی تعیین میکند، مهم نیست از چه شتابدهندهها و پردازندههای مرکزی هوش مصنوعی استفاده شود.
پایان دادن به اختلافات؟
بدون شک، انویدیا (Nvidia) یک تامینکننده پیشرو در سختافزار مرکز داده است، بنابراین اگر این دو شرکت واقعاً روی پلتفرم مرکز داده اپل با یکدیگر همکاری کنند، منطقی است که اپل با این شرکت همکاری کند.
اپل (Apple) و انویدیا (Nvidia) لزوماً شرکای خوبی نیستند. خصومت بین این دو شرکت در اواخر دهه ۲۰۰۰ آغاز شد، زمانی که استیو جابز (Steve Jobs) انویدیا را به نقض پتنتهای پیکسار متهم کرد که انویدیا در پاسخ گفت که مالک مالکیت معنوی گرافیکی بیشتری نسبت به پیکسار است و بنابراین میتواند از این شرکت شکایت کند. بعداً، اپل و انویدیا بر سر تصمیمات طراحی پردازنده گرافیکی که دومی به اولی عرضه کرده بود، اختلاف نظر داشتند. با این حال، سپس «بامپگیت» (Bumpgate) پیش آمد زیرا انویدیا در سالهای ۲۰۰۷ تا ۲۰۰۸ پردازندههای گرافیکی معیوب را به اپل و سایر سازندگان رایانههای شخصی عرضه کرد، مشکل را تصدیق نکرد و سپس در برابر جبران کامل هزینههای تعمیر اپل و سایر سازندگان رایانههای شخصی مقاومت کرد، که در این زمان رابطه بین شرکتها به ویژه وخیم شد. اپل به استفاده از پردازندههای گرافیکی انویدیا تا سال ۲۰۱۴ یا ۲۰۱۵ ادامه داد، در آن نقطه به رادئون (Radeon) شرکت ایامدی (AMD) تغییر وضعیت داد و سپس پردازندههای گرافیکی مجزا شخص ثالث را بهطور کامل کنار گذاشت.
ا اخیراً، اپل دوباره شروع به استفاده از سختافزار انویدیا کرده است. آخرین هوش مصنوعی سیری در درجه اول توسط مدلهای پایه اپل که با همکاری گوگل با استفاده از فناوری جمنای (Gemini) توسعه یافتهاند، پشتیبانی میشود. استنتاج سمت سرور از طریق معماری محاسبات ابری خصوصی (Private Cloud Compute) اپل اجرا میشود و بسیاری از بارهای کاری بر روی واحدهای پردازش گرافیکی بلکول (Blackwell) انویدیا در ابر گوگل میزبانی میشوند. با این حال، استفاده از سختافزار انویدیا در ابر و اتخاذ فناوریهای این شرکت برای پلتفرمهای خودتان، مسئلهام کاملاً متفاوتی است.
منبع: tomshardware.com