
امروز، قابلیت جدیدی را برای آمازون اورورا پستگرسکیوال (Amazon Aurora PostgreSQL) معرفی میکنیم که میتوانید از آن برای پرسوجوی مستقیم دادههای عملیاتی به همراه دادههای ذخیرهشده در دریاچه داده در قالبهای آپاچی ایسبرگ (Apache Iceberg) و آپاچی پارکت (Apache Parquet)، با استفاده از برنامهها و ابزارهای موجود پستگرسکیوال (PostgreSQL) خود استفاده کنید. با حذف نیاز به استخراج، تبدیل و بارگذاری (ETL) دادههای ساختاریافته از دریاچههای داده به پایگاه داده عملیاتی، میتوانید پیچیدگی عملیاتی را کاهش داده و توسعه برنامه را سادهتر کنید. همچنین میتوانید از اورورا پستگرسکیوال (Aurora PostgreSQL) برای پرسوجوی دادهها از دریاچههای داده مدیریتشده در کاتالوگهای سازگار با ایسبرگ رست کاتالوگ (Iceberg REST Catalog) استفاده کنید که به شما امکان دسترسی به دادهها را در طیف گستردهای از سیستمهای تحلیلی بدون جابجایی یا تکثیر آنها میدهد. چه در حال توانمندسازی داشبوردهای بلادرنگ باشید، چه تراکنشها را با زمینه تاریخی غنیسازی کنید، یا ایجنتهای هوش مصنوعی (AI agents) بسازید که روی دادههای زنده و بایگانیشده استدلال میکنند، اکنون میتوانید همه این کارها را از طریق یک رابط واحد و آشنا انجام دهید.
پیش از این، اگر برنامه شما نیاز داشت که دادههای تراکنشی اخیر را در اورورا (Aurora) با سوابق تاریخی ذخیرهشده در آمازون استری (Amazon S3) ترکیب کند، یک رویکرد رایج، ساخت خطوط لوله ETL معکوس بود که دادهها را تکثیر میکرد، هزینههای زیرساختی را افزایش میداد و نیازمند تلاش مهندسی مداوم برای همگام نگه داشتن همه چیز بود. این چالش تنها با افزایش بهکارگیری ایجنتهای هوش مصنوعی در برنامههای شما رشد میکند، جایی که پیشبینی و پیشتکثیر هر مجموعه دادهای که یک ایجنت ممکن است به آن نیاز داشته باشد، غیر عملی است.
تیم داکلبز (DuckLabs)، که پروژه داکدیبی (DuckDB) را نگهداری میکند، اخعراً به آمازون پیوسته است و این قابلیت نمونهای از نحوه ادغام کارایی DuckDB در خدمات ما است. داکدیبی (DuckDB) اکنون مستقیماً در اورورا پستگرسکیوال (Aurora PostgreSQL) تعبیه شده است، بنابراین میتوانید دادههای عملیاتی زنده (از جمله نوشتههای ثبتنشده) را در کنار دریاچه داده خود در یک پرسوجوی واحد جستجو کنید. پردازش پرسوجو در اورورا باقی میماند، بدون پرشهای شبکه اضافی و بدون خطوط لوله ETL که دادهها را تکثیر کنند. شما میتوانید جدولهای آپاچی ایسبرگ (Apache Iceberg) مدیریتشده از طریق کاتالوگ داده ایدابلیوتیاس گلو (AWS Glue Data Catalog) و همچنین دادههای پارکت (Parquet) و ایسبرگ (Iceberg) ذخیرهشده در آمازون استری (Amazon S3) و جدولهای استری (S3 Tables) را پرسوجو کنید. شما همه این کارها را با استفاده از نحو آشنای پستگرسکیوال (PostgreSQL) و برنامهها و ابزارهای موجود خود انجام میدهید.
ما از آوردن سرعت و سادگی DuckDB مستقیماً به اورورا پستگرسکیوال (Aurora PostgreSQL) هیجانزده هستیم، بهطوریکه شما و ایجنتهایتان میتوانید دادههای عملیاتی و ایسبرگ (Iceberg) را با استفاده از برنامهها، ابزارها و نقاط پایانی آشنای پستگرسکیوال (PostgreSQL) که قبلاً در حال استفاده هستند، جستجو و ترکیب کنید. با ساختن این قابلیت پیرامون DuckDB، بهبودهای آینده در موتور متنباز میتواند همچنان دستاوردهای عملکردی و کارایی را برای اورورا و سایر خدمات ایدابلیوتیاس (AWS) به ارمغان بیاورد.
چه چیزی جدید است
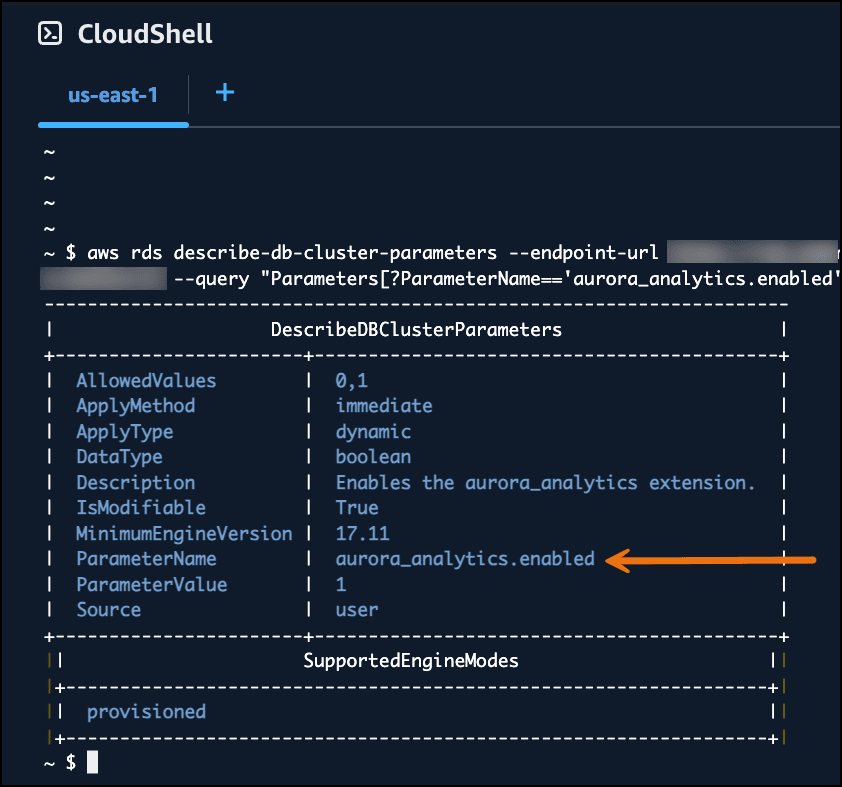
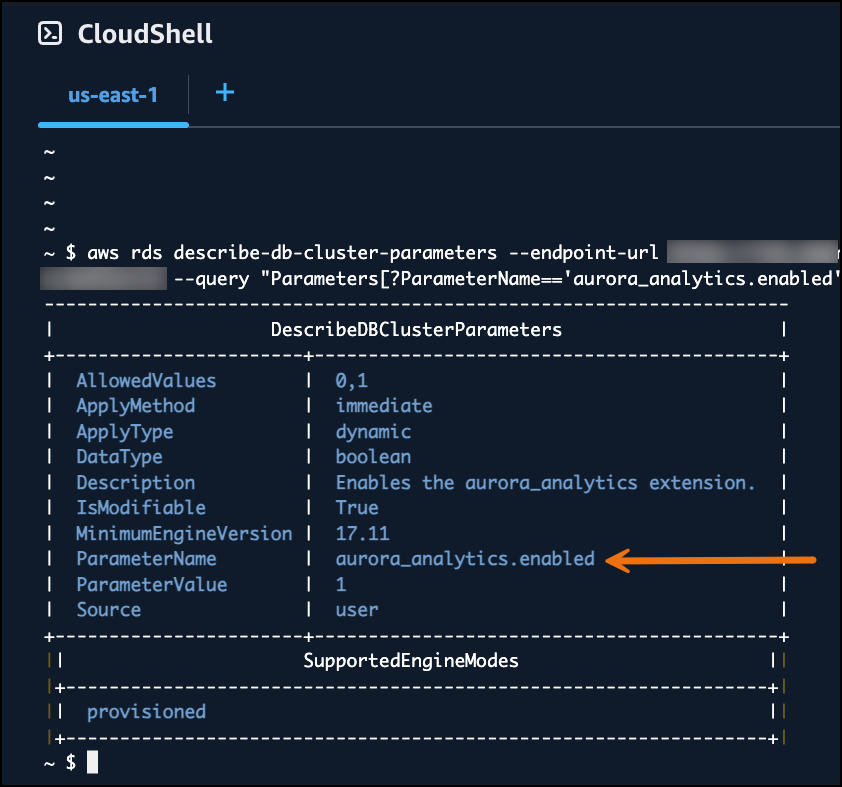
این قابلیت در دو نسخه اصلی اورورا پستگرسکیوال (Aurora PostgreSQL) پشتیبانی میشود: نسخه 17 (شروع از 17.11) و نسخه 18 (شروع از 18.6). برای استفاده از آن، یک خوشه (Cluster) اورورا پستگرسکیوال ایجاد میکنید، یک نقش آیام (IAM role) با ویژگی AuroraAnalytics را متصل میکنید و افزونه aurora_analytics را فعال میسازید. نقش IAM همان چیزی است که به اورورا دسترسی به دادههای شما در آمازون استری (Amazon S3) و کاتالوگ داده AWS Glue را میدهد. سپس جدولهای مجازی (Foreign tables) ایجاد میکنید که به دادههای ایسبرگ یا پارکت شما در دریاچه داده اشاره میکنند و با استفاده از نحو آشنای پستگرسکیوال به پرسوجوی آنها میپردازید. شما میتوانید این راهاندازی را از طریق کنسول آمازون آردیاس (Amazon RDS) یا با هر کلاینت پستگرسکیوال مانند psql انجام دهید. این روند به خوبی در مستندات اورورا پستگرسکیوال مستند شده است.
شما میتوانید دادهها را در کاتالوگهای خارجی سازگار با IRC از طریق فدراسیون کاتالوگ داده AWS Glue جستجو کنید. شما کاتالوگ خارجی را یک بار در Glue ثبت میکنید و سپس جدولهای مجازی را برای جدولهایی که میخواهید پرسوجو کنید، دقیقاً همانند هر جدول بومی Glue ایجاد میکنید. سپس یک پرسوجو میتواند دادههای ذخیرهشده در اورورا را با جدولهای ایسبرگ ثبتشده در چندین کاتالوگ بپیوندد (Join)، بهطوریکه برنامهها بدون جابجایی دادهها یا جایگزینی سرمایهگذاریهای کاتالوگ موجود خود، یک نمای واحد دریافت کنند.
اورورا همچنین بهینهسازیهایی مانند انتقال پیششرط (Predicate pushdown) و هرس ستون (Column pruning) را اعمال میکند تا فقط دادههای مربوطه خوانده شوند. این کار باعث میشود که پرسوجوها حتی با رشد دادههای زیربنایی کارآمد باقی بمانند. دادههای پرکاربرد نیز در نمونه اورورا شما کش میشوند، بهطوریکه پرسوجوهای بعدی روی همان دادهها سریعتر پاسخ میدهند. شما میتوانید این رفتار را به ازای هر پرسوجو با استفاده از aurora_analytics_stat_statements() بررسی کنید که معیارهایی مانند سطرهای اسکنشده، بایتهای خواندهشده از آمازون استری و موارد یافتشده در کش را گزارش میکند.
برای دیدن نحوه کارکرد پرسوجوی مستقیم، با استفاده از psql به پایگاه داده اورورا پستگرسکیوال خود متصل شدم و افزونه را ایجاد کردم:
CREATE EXTENSION aurora_analytics;برای بررسی خودم، یک سناریوی مالی ساده را راهاندازی کردم. من یک جدول recent_transactions در اورورا با 7 روز آخر تراکنشهای مشتری دارم و یک فایل Parquet در آمازون استری حاوی 5 سال دادههای تراکنش تاریخی است. برای اینکه اورورا از دادههای تاریخی مطلع شود، یک جدول مجازی که به فایل Parquet در S3 اشاره دارد ایجاد کردم:
CREATE FOREIGN TABLE transaction_history ()
SERVER aurora_analytics_server
OPTIONS (
    location 's3://<my-bucket>/finance/transaction_history.parquet',
    format 'parquet'
);
به پرانتزهای خالی در دستور CREATE FOREIGN TABLE توجه کنید. اورورا به طور خودکار طرحواره (Schema) را از ابرداده فایل Parquet میخواند، بنابراین نیازی به تعریف دستی ستونها ندارید. برای بارهای کاری با جدولهای فراوان، میتوانید ایجاد تکتک آنها را رد کنید: یک دستور واحد IMPORT FOREIGN SCHEMA جدولهای مجازی را به صورت دستهای برای هر جدول Iceberg یا Parquet در یک پایگاه داده کاتالوگ داده AWS Glue ایجاد میکند و طرحوارهها را به طور خودکار استنتاج میکند.
با قرار گرفتن هر دو جدول در جای خود، یک پرسوجوی واحد اجرا کردم که دادههای عملیاتی اخیر در اورورا را با دادههای تاریخی در S3 ترکیب میکند:
SELECT merchant, category, amount, transaction_date, 'recent' AS source
FROM recent_transactions
WHERE customer_id = 'C-1001'
UNION ALL
SELECT merchant, category, amount, transaction_date, 'historical' AS source
FROM transaction_history
WHERE customer_id = 'C-1001'
  AND transaction_date >= CURRENT_DATE - INTERVAL '5 years'
ORDER BY transaction_date DESC
LIMIT 15;
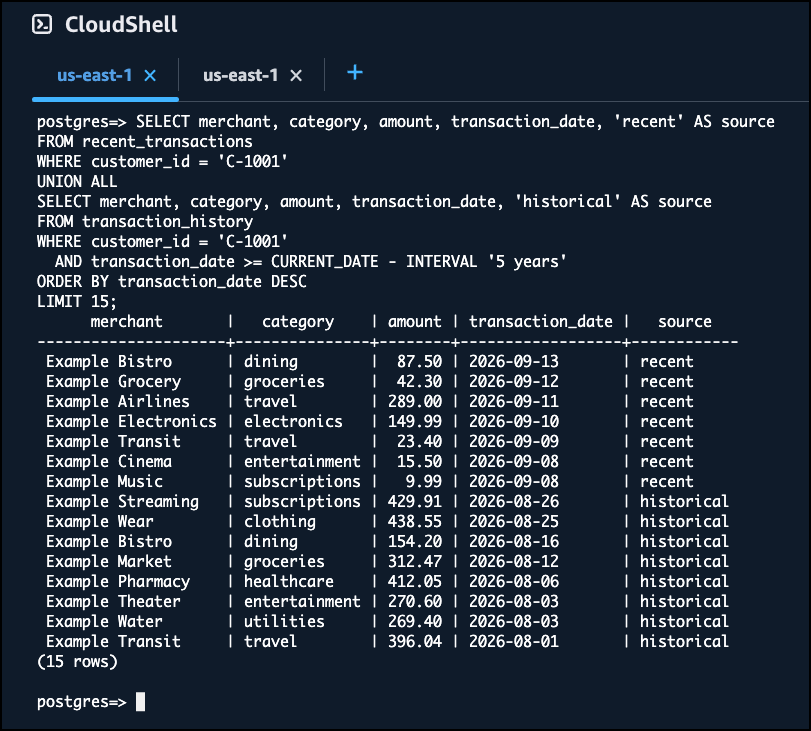
نتیجه هم تراکنشهای اخیر و هم تاریخی را در یک مجموعه نتیجه واحد نشان میدهد. 7 سطر اخیر از اورورا میآیند و بقیه مستقیماً از فایل Parquet در S3 میآیند. داکدیبی (DuckDB) اسکن تحلیلی دادههای پارکت را در پشت صحنه انجام میدهد، در حالی که اورورا دادههای عملیاتی را مدیریت میکند. آن پرسوجوی واحد قبلاً به یک خط لوله نیاز داشت تا ابتدا دادههای تاریخی را به پایگاه داده منتقل کند.
اگر یک الگوی پرسوجو به تأخیر (Latency) تکرقمی میلیثانیهای نیاز داشته باشد، میتوانید دادهها را از دریاچه داده به یک جدول بومی اورورا پستگرسکیوال با استفاده از دستورات آشنا مانند CREATE TABLE AS SELECT، INSERT INTO ... SELECT، یا MERGE INTO مادیسازی (Materialize) کنید. جدول مادیشده در اورورا زندگی میکند و مانند هر جدول دیگر پستگرسکیوال جستجو میشود و یک مسیر با تاخیر کم برای دادههای داغ بدون اجرای یک خط لوله مصرف جداگانه در اختیار شما قرار میدهد. پرسوجوهای خواندن میتوانند روی هر نمونه اورورا پستگرسکیوال در خوشه شما اجرا شوند، چه نویسنده (Writer) و چه نمونه خواندنی (Read replica)، بنابراین میتوانید اسکنهای تحلیلی را از بار کاری عملیاتی خود خارج کنید. دستورات مادیسازی دادهها را در اورورا مینویسند، بنابراین روی نمونه نویسنده اجرا میشوند.
امروز شروع کنید
پرسوجوی مستقیم دادههای آپاچی ایسبرگ و پارکت از آمازون اورورا پستگرسکیوال امروز در تمام مناطق تجاری AWS و مناطق AWS GovCloud (ایالات متحده) بدون هیچ هزینه اضافی در دسترس است. شما فقط هزینه محاسبات افزایشی اورورا که پرسوجوها مصرف میکنند و هزینههای درخواست آمازون استری برای خواندن فایلهای دریاچه داده را پرداخت میکنید.
برای کسب اطلاعات بیشتر، به صفحه ویژگیهای آمازون اورورا مراجعه کنید، مستندات اورورا پستگرسکیوال را بخوانید، یا آن را در کنسول آمازون RDS امتحان کنید. ما از بازخوردهای شما از طریق AWS re:Post یا مخاطبین معمول پشتیبانی AWS استقبال میکنیم.
— Esra
منبع: aws.amazon.com