
اکتشافات هوش مصنوعی محلی ما در سال ۲۰۲۶ تاکنون بر روی دو پلتفرم اصلی متمرکز بوده است: GB10 انویدیا (Nvidia)، همانطور که در DGX Spark و Dell Pro Max با GB10 دیده میشود، و Ryzen AI Max+ 395 ایامدی (AMD)، با نام مستعار استریکس هالو (Strix Halo)، همانطور که در Corsair AI Workstation 300 و Ryzen AI Halo دیده میشود. ما معمولاً سیستمهای GB10 را برای این نوع محیطهای توسعه هوش مصنوعی محلی ترجیح دادهایم. عملکرد همهجانبه خوب و سازگاری گسترده نرمافزار هوش مصنوعی آنها را محبوب کرده است، حتی اگر توان عملیاتی استنتاج مدل زبانی بزرگ (LLM) چندان بالا نباشد.
اما مک استودیو اپل (Apple Mac Studio) گزینه جذاب دیگری برای پیشتازان هوش مصنوعی محلی است که سیستمهایی با استخرهای حافظه یکپارچه بزرگ، پردازندههای گرافیکی قدرتمند و پهنای باند حافظه بالا میخواهند تا توان عملیاتی سریعتری به ازای هر ثانیه توکن نسبت به GB10 یا استریکس هالو فراهم کنند. و تا زمانی که شخص دیگری سیستم روی تراشه (SoC) حافظه یکپارچه دیگری با باس حافظه به پهنای آنچه اپل برای تراشههای Max و Ultra خود استفاده میکند بسازد، اپل سیلیکون (Apple Silicon) در واقع تنها گزینه موجود برای پهنای باند حافظه بیشتر از یک تراشه با این طراحی است.
چرا اصلاً روی پهنای باند حافظه برای عملکرد محلی LLM تمرکز زیادی کنیم؟ برای کوتاه کردن بسیار زیاد، فاز رمزگشایی استنتاج LLM تقریباً همیشه به صورت ترتیبی است. هر توکن خروجی (با شروع اولین توکنی که به عنوان بخشی از فرآیند پیش پر کردن تولید میشود) باید از تمام لایههای یک مدل عبور کند تا توکن بعدی تولید شود، و بنابراین تمام وزنهای مدل فعال در یک له باید با حرکت توکن در هر یک از آنها، از حافظه خود به پردازنده گرافیکی جریان پیدا کنند.
از آنجایی که میزان محاسبات مورد نیاز برای هر توکن فردی در هر لایه بسیار ناچیز است، سرعت کل فرآیند رمزگشایی اساساً به میزان سرعت جریان یافتن آن وزنهای مدل از حافظه پردازنده گرافیکی بستگی دارد. این امر سیستمهایی با استخرهای حافظه بزرگ (برای نگه داشتن مدلهای بزرگ) و پهنای باند حافظه بالا (برای جریان دادن آن وزنهای مدل به پردازنده گرافیکی) را جذاب میکند و اپل سیلیکون تنها پلتفرمی است که به شما امکان میدهد هر دو ویژگی را با هزینهای (نسبتاً) معقول داشته باشید.
آخرین بهروزرسانی مک استودیو اپل در مارس ۲۰۲۵ انجام شد و نشاندهنده معرفی دو نسخه از سیستم بود. نسخه ردهبالاتر از تراشه M3 Ultra SoC با پهنای باند حافظه ۸۱۹ گیگابایت بر ثانیه در هر دو مدل ۲۸ هسته پردازنده مرکزی، ۶۰ هسته پردازنده گرافیکی و مدل ۳۲ هسته پردازنده مرکزی، ۸۰ هسته پردازنده گرافیکی استفاده میکند.
نسخه M4 Max مک استودیو شامل دو نسخه با واگرایی بیشتر در مشخصات نسبت به تعداد هسته است. پایه M4 Max شامل یک پردازنده مرکزی ۱۴ هستهای (۱۰ هسته عملکردی و چهار هسته بهرهوری) با پهنای باند حافظه ۴۱۰ گیگابایت بر ثانیه است و میتوان آن را به یک پردازنده مرکزی ۱۶ هستهای (۱۲ هسته عملکردی و چهار هسته بهرهوری) با پهنای باند حافظه ۵۴۶ گیگابایت بر ثانیه ارتقا داد.
ما هر دوی این سیستمها را در زمان عرضه بررسی کردیم، اما اپل به طور سخاوتمندانهای یک M4 Max دیگر با پردازنده مرکزی ۱۶ هستهای، پردازنده گرافیکی ۴۰ هستهای و ۱۲۸ گیگابایت حافظه را برای تستهای خاص LLM به ما قرض داد. در آن زمان، قیمت آن سیستم حدود ۳,۶۹۹ دلار بود که به قیمت لیست ۳,۹۹۹ دلاری DGX Spark نزدیک بود.
اما با ادامه یافتن بحران رم (RAMpocalypse)، مک استودیو در گزینههای پیکربندی خود محدودتر شده و پیدا کردن آن در انبار دشوارتر شده است. نسخه M4 Max که ما آزمایش کردیم اکنون حداکثر دارای ۶۴ گیگابایت رم است و زمان تحویل آن سیستم بیش از دو ماه است. صرف نظر از این، این قابل مقایسهترین سیستمی است که اپل برای پلتفرمهای DGX Spark و GB10 به طور کلی دارد، حداقل به زمانی که دلار به دلار در این بازار معنایی داشت.
قبل از اینکه وارد نتایج عملکرد شویم، میخواستیم جزئیات پردازنده گرافیکی ۴۰ هستهای M4 Max را بررسی کنیم، اما اپل اطلاعات معماری دقیق زیادی (در صورت وجود) را در مورد پردازندههای گرافیکی خود، از جمله تعداد ALUهای سایهزن که هر هسته پردازنده گرافیکی را تشکیل میدهند، به اشتراک نمیگذارد، بنابراین مقایسه مستقیم M4 Max با GB10 یا Radeon 8060S در Ryzen AI Max+ 395 دشوار است.
انویدیا GB10 (Nvidia GB10) | ایامدی Ryzen AI Max+ 395 (AMD Ryzen AI Max+ 395) | اپل M4 مکس (پردازنده مرکزی ۱۶ هستهای، پردازنده گرافیکی ۴۰ هستهای) | |
|---|---|---|---|
موجود در | |||
هستههای عملکردی پردازنده مرکزی | ۱۰ | ۱۶ | ۱۲ |
هستههای بهرهوری پردازنده مرکزی | ۱۰ | ۴ | |
تعداد هستههای پردازنده گرافیکی / SM / CU | ۴۸ | ۴۰ | ۴۰ |
واحد محاسباتی سایهزن (Shader ALUs) | ۶,۱۴۴ | ۲,۵۶۰ | ۵,۱۲۰ (؟) |
کلاک پردازنده گرافیکی | ~۲۴۵۰ مگاهرتز (معمولی) | ۲۹۰۰ مگاهرتز | ؟؟؟ |
حافظه یکپارچه | ۱۲۸ گیگابایت LPDDR5X-8533 | ۱۲۸ گیگابایت LPDDR5X-8000 | ۱۲۸ گیگابایت LPDDR5X-8533 (؟) |
پهنای باس حافظه | ۲۵۶ بیت | ۲۵۶ بیت | ۵۱۲ بیت (؟) |
پهنای باند حافظه (گیگابایت بر ثانیه) | ۲۷۳ | ۲۵۶ | ۵۴۶ |
Radeon 8060S روی برد Strix Halo دارای ۴۰ واحد محاسباتی RDNA 3.5 است که هر کدام دارای ۶۴ واحد محاسباتی سایهزن برای مجموع ۲,۵۶۰ واحد هستند. ایامدی سرعت کلاک 8060S را بالا و روی 2900 مگاهرتز تنظیم کرده است تا به حدود 14.8 ترافلاپس (TFLOPS) ریاضی برداری FP32 اوج خود برسد.
در همین حال، GB10 دارای ۴۸ واحد بلکول SM با ۱۲۸ واحد محاسباتی سایهزن برای مجموع ۶,۱۴۴ هسته کودا (CUDA) است و آن نیز در آزمایش ما نسبتاً بالا و روی ۲۴۵۰ مگاهرتز کلاک دارد. این تراشه ۳۰ ترافلاپس تئوری خیرهکننده از محاسبات برداری FP32 را ارائه میدهد.
با این حال، در زمانهای گذشته که اپل برای اولین بار پردازنده گرافیکی M1 را آشکار کرد، این شرکت فاش کرد که هر هسته شامل ۱۲۸ واحد اجرایی است. با فرض اینکه همان سازماندهی به پردازندههای گرافیکی فعلی اپل منتقل شده باشد، پردازنده گرافیکی ۴۰ هستهای M4 Max دارای ۵,۱۲۰ واحد اجرایی یا واحد محاسباتی سایهزن خواهد بود. این حداقل ایدهای از مقیاس پردازنده گرافیکی ارائه میدهد، البته بدون دانستن سرعت کلاک، ما از گمانهزنی بیشتر در مورد ترافلاپس اوج یا سایر معیارهای عملکرد تئوری خودداری میکنیم.
اپل همچنین تنها ارقام پهنای باند حافظه خام را برای M4 Max ارائه میدهد، اما ما میتوانیم برخی محاسبات سرانگشتی انجام دهیم تا حدس بزنیم که این تراشه احتمالاً از LPDDR5X-8533 روی یک باس ۵۱۲ بیتی برای دستیابی به پهنای باند حافظه رتبهبندی شده ۵۴۶ گیگابایت بر ثانیه استفاده میکند، که دو برابر پهنای باند هر دو GB10 و Strix Halo است. M4 Max رده پایینتر احتمالاً از LPDDR5X-6400 استفاده میکند. به نوبه خود، M3 Ultra احتمالاً از یک باس ۷۶۸ بیتی با LPDDR5X-8533 در هر دو نسخه خود استفاده میکند.
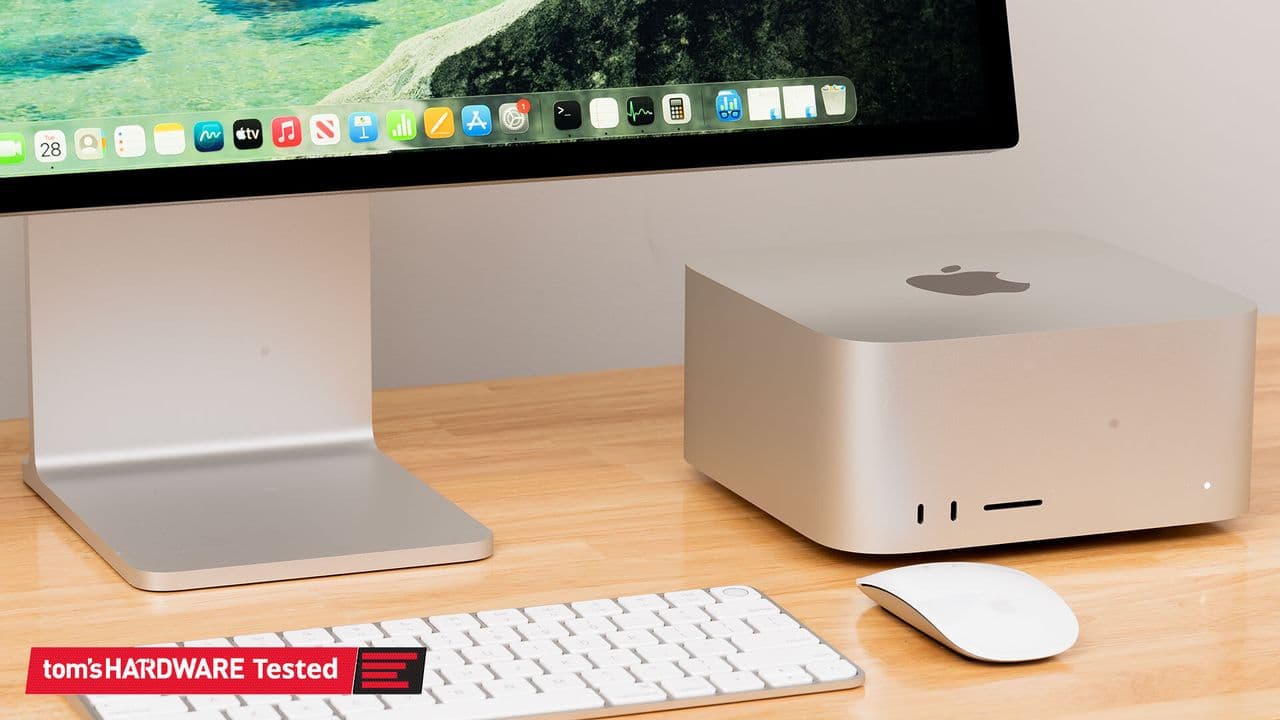
ما طراحی مک استودیو را در بررسی اولیه خود به تفصیل پوشش دادیم، اما ارزش دارد که یک تور سریع برای آشنایی مجدد با آن داشته باشیم. بالا و کنین مک استودیو تا حد زیادی بدون ویژگی است، به جز یک لوگوی مشکی اپل منبتکاری شده در بالا. پنل جلویی دارای دو پورت USB Type-C با سرعت ۱۰ گیگابیت بر ثانیه و یک کارتخوان UHS-II SD است.
طراحی حرارتی استودیو از یک سیستم ورودی هوشمند استفاده میکند که هوا را از دریچههای اطراف پایه دایرهای سیستم میکشد قبل از اینکه آن را از طریق یک دریچه در پشت شاسی خارج کند.
M4 Max Studio که ما آزمایش کردیم دارای چهار پورت تاندربولت ۵ (Thunderbolt 5) در پنل پشتی خود با پشتیبانی از نرخ داده تا ۱۲۰۰ گیگابایت بر ثانیه است. اگرچه ما امروز آن را آزمایش نمیکنیم، اما میتوانید RDMA را روی تاندربولت ۵ برای خوشهبندی با تاخیر کم مک استودیوها با استفاده از ابزارهایی مانند Exo فعال کنید. این پورتها همچنین از نمایشگرهای تاندربولت یا حالت DisplayPort 2.1 Alt پشتیبانی میکنند.
این سیستم همچنین دارای دو پورت USB 3 با سرعت ۵ گیگابیت بر ثانیه، اترنت ۱۰ گیگابایتی، یک پورت HDMI 2.1 و یک جک هدفون است، بنابراین تمام اتصالاتی را که عملاً از یک دسکتاپ جمعوجور در سال ۲۰۲۶ میخواهید، دارد.
با خارج کردن این اصول اولیه، بیایید به سراغ آزمایش برویم.
برای آزمایش عملکرد استنتاج LLM، ما بار دیگر به llama.cpp روی میآوریم که وقتی از منبع ساخته میشود، از پشتیبانی بومی Metal/MLX روی اپل سیلیکون پشتیبانی میکند. ما از پروژه llama-benchy به عنوان مهار بنچمارک خود استفاده کردیم.
ما سه مدل از ردپاهای حافظه و معماریهای مختلف را آزمایش کردیم: Qwen 3.6-35B-A3B، یک مدل ترکیبی از متخصصان اخیر؛ Gemma 4 12B، یک مدل متراکم کوچک؛ و gpt-oss-120b ساخت OpenAI، یک مدل ترکیبی بزرگ از متخصصان. ما از کوانتسازیهای چهار بیتی Unsloth از این مدلها برای آزمایش خود استفاده کردیم.
با Qwen 3.6-35B-A3B، مک استودیو سرعت پردازش پرامپتی را ارائه میدهد که از Strix Halo بهتر است اما همچنان عقبتر از GB10 است، به ویژه با زمینههای طولانیتر.
به سراغ نتایج توان عملیاتی بروید و M4 Max از هر دو GB10 و Strix Halo جلو میزند و توان عملیاتی بالاتری به ازای هر ثانیه توکن نسبت به هر دو سیستم در تمام عمقهای زمینه ارائه میدهد.
اما با وجود داشتن دو برابر پهنای باند حافظه GB10 و Strix Halo روی کاغذ، بهبود دنیای واقعی در توان عملیاتی توکن در M4 Max تنها ۲۵ درصد روی Qwen 3.6-35B-A3B است. این قطعاً استقبال میشود، اما اصلاً سرعت افزایشی نیست که ممکن است با دو برابر پهنای باند حافظه موجود انتظار داشته باشید.
از طرف دیگر، Gemma 4 12B متراکم واقعاً به نظر میرسد به مزیت پهنای باند مک استودیو اجازه میدهد بدرخشد. توان عملیاتی توکن بر ثانیه با این مدل به طور خطیتری با پهنای باند حافظه مقیاس میشود، و بنابراین مک استودیو افزایش توان عملیاتی ۱.۸ برابری نسبت به GB10 و افزایش ۲.۲۶ برابری نسبت به Strix Halo ارائه میدهد.
اما سرعت پردازش پرامپت در اینجا فقط با (یا حتی کمی بدتر از) Strix Halo مطابقت دارد، که اگر تأخیر برای برنامه شما مهم باشد، نتیجه فوقالعادهای نیست.
در نهایت، ما به gpt-oss-120b نگاه خواهیم کرد. پردازش پرامپت بار دیگر بین Strix Halo و GB10 قرار میگیرد و توان عملیاتی توکن بر ثانیه بسیار بالاتر از هر یک از آن سیستمها است. اما توان عملیاتی توکن بر ثانیه مک استودیو، به طور متوسط، ۱.۵ برابر بیشتر از GB10 و ۱.۶ برابر بیشتر از Strix Halo است، علیرغم پهنای باند حافظه بسیار بالاتر آن. اینها هنوز پیشتازیهای چشمگیری هستند، اما نشان میدهند که پهنای باند حافظه تنها یکی از اجزا در قضاوت درباره عملکرد یک خط لوله استنتاج است.
در مجموع، آزمایش استنتاج LLM ما نشان میدهد که پردازنده گرافیکی M4 Max میتواند توکنهای بسیار بیشتری در ثانیه نسبت به سیستمهای رقیب با استخرهای حافظه یکپارچه بزرگ تولید کند، اما مشخصات پهنای باند حافظه به تنهایی نماینده خوبی برای عملکرد تحویل داده شده نیست. تقویت واقعی که از M4 Max در استنتاج LLM دریافت میکنید به شدت به معماری مدلی که میخواهید اجرا کنید بستگی دارد، بنابراین بنچمارکگیری دنیای واقعی همچنان مهم است.
عملکرد تولید تصویر
LLMها تنها بار کاری هوش مصنوعی نیستند که ممکن است بخواهید به صورت محلی اجرا کنید. تولید تصویر و ویدیو نیز اهمیت دارد و عملکرد این مدلهای انتشاری به طور کلی توسط توان عملیاتی محاسباتی پردازنده گرافیکی زیرین محدود میشود.
اجرای تست تولید تصویر Flux.2 Klein ما روی مک استودیو در ابتدا به دلیل کمبود آشکار پشتیبانی پردازنده گرافیکی از نوع داده FP8 که جریان کاری ComfyUI به طور پیشفرض استفاده میکند، با شکست مواجه شد.
ما توانستیم جریان کاری ComfyUI را تغییر دهیم تا از نسخه پایه FP16 Flux.2 Klein روی مک استودیو استفاده کنیم، اما این مشکل سازگاری اولیه نشان میدهد که ممکن است تجربه تولید تصویر یا ویدیوی به هم پیوستهای روی اپل سیلیکون مانند GB10 یا حتی Strix Halo نداشته باشید.
علاوه بر مسائل سازگاری، پردازنده گرافیکی M4 Max به زمان بیشتری حتی نسبت به Radeon 8060S در این تست تولید تصویر نیاز دارد. انویدیا بارها در دموی خود در سال جاری نشان داده است که DGX Spark به عنوان یک همراه تولید تصویر و ویدیو برای مکها کار میکند و این نتیجه نشان میدهد که چرا این جفتشدن ممکن است منطقی باشد.
عملکرد تولید تصویر با آخرین پردازنده گرافیکی M5 و شتابدهندههای عصبی اختصاصی آن برای ریاضیات ماتریس ممکن است در اینجا بهتر باشد، اما ما یک سیستم مجهز به M5 را در دست نداریم تا با M4 Max مقایسه کنیم. اپل ادعا میکند که M5 Max در تولید تصویر «تا ۳.۸ برابر سریعتر» از M4 Max است، بنابراین اگر این بار کاری برای شما مهم است، به آن توجه کنید.
عملکرد عمومی پردازنده مرکزی
ما قبلاً عملکرد پردازنده مرکزی M4 Max را در بررسی اولیه خود ارزیابی کرده بودیم، اما میخواستیم آن را مستقیماً در برابر Strix Halo و GB10 قرار دهیم تا ببینیم چگونه در فضای هوش مصنوعی در برابر این پلتفرمهای محبوب عمل میکند. برای تعیین یک محدوده عملکرد پردازنده مرکزی برای M4 Max، ما Geekbench 7 تازه منتشر شده را راهاندازی کردیم و به سراغ آن رفتیم.
در این بنچمارک، M4 Max یک مزیت خیرهکننده ۲۷ درصدی در عملکرد تکهستهای و یک تقویت ۲۱ درصدی در عملکرد چندرشتهای در مقایسه با پردازنده مرکزی x86 Zen 5 شانزده هستهای و ۳۲ رشتهای Ryzen Max+ 395 ارائه میدهد.
و با مقایسه Arm با Arm، M4 Max یک مزیت تکهستهای ۳۹ درصدی نسبت به هسته «بزرگ» Cortex-X925 روی Nvidia GB10 به همراه یک مزیت ۲۲ درصدی در کار چندرشتهای ارائه میدهد.
این نتایج به خودی خود بسیار چشمگیر هستند، اما اپل اکنون هستههای پردازنده مرکزی پیشرفتهتری را در زرادخانه خود روی سری M5 دارد. ما انتظار مزیتهای حتی بزرگتری در استفاده عمومی از آن تراشهها داریم.
گیکبنچ (Geekbench) برای یک تست مصنوعی سریع خوب است، اما میخواستم مطمئن شوم که نتایج آن در یک وظیفه دنیای واقعی حفظ میشود، بنابراین نسخه فقط پردازنده مرکزی llama.cpp را از منبع در هر سه سیستم آزمایشی خود با استفاده از کامپایلر Clang 21 که در تمام هستههای فیزیکی موجود اجرا میشود، کامپایل کردم.
با تمام ۱۶ هسته پردازنده مرکزی آن در بازی، M4 Max این کار کامپایل را در حدود ۳۷ ثانیه به پایان میرساند، که هر جایی بین ۳۳ تا ۳۷ درصد سریعتر از رقابت انویدیا و ایامدی در اینجا است. این حتی سریعتر از چیزی است که دلتا عملکرد چندرشتهای Geekbench مدل M4 Max پیشنهاد میکند.
حداقل با قضاوت بر اساس این تستهای سطح بالا، عملکرد پردازنده مرکزی اپل در میان SoCها با استخرهای حافظه یکپارچه بزرگ، بهترین در کلاس خود و با اختلاف زیاد است. و بار دیگر، این با M4 نسل قبلی است، نه آخرین نسل M5.
هنگام قضاوت در مورد کارایی اپل سیلیکون یا هر پلتفرم دیگری، ممکن است وسوسه شوید که فقط به یک متر قدرت مانند Kill-a-Watt با سیستم تحت بار نگاه کنید و آن را رها کنید، اما مصرف انرژی لحظهای معیار مناسبی هنگام قضاوت در مورد کارایی یک سیستم برای یک وظیفه مشخص نیست.
انرژی وظیفه (مقدار انرژی مصرف شده در طول زمان) بسیار آموزندهتر است. سیستمی که به انرژی زیادی نیاز دارد اما یک وظیفه را به سرعت به پایان میرساند ممکن است انرژی وظیفه کمتری مصرف کند و بنابراین کارآمدتر از سیستمی است که مقدار متوسطی از انرژی را مصرف میکند اما زمان زیادی طول میکشد تا کار را تمام کند.
برای قضاوت در مورد کارایی استنتاج، ما یک بار کاری با طول ثابت با gpt-oss-120b با استفاده از llama.cpp و llama-benchy تنظیم کردیم: ابتدا پردازش یک پرامپت ۲۰۴۸ توکنی در برابر عمق زمینه ۳۲۷۶۸ توکنی، سپس تولید ۱۰۲۴ توکن خروجی. ما آن عمق زمینه را انتخاب کردیم تا مطمئن شویم آزمایش ما به اندازه کافی طولانی اجرا میشود تا دادههای مفیدی جمعآوری شود. ما این داده را بر حسب وات-ساعت ثبت کردیم تا هم انرژی مصرف شده و هم زمان تا اتمام را منعکس کند.
حداقل در این بار کاری مصنوعی، M4 Max کارآمدتر از Strix Halo است، اما سرعت خالص پردازش پرامپت GB10 به آن اجازه میدهد بسیار سریعتر به پایان برسد و توان کل کمتری نسبت به مک استودیو مصرف کند، حتی اگر توکنهای کمتری در ثانیه در مرحله رمزگشایی تولید کند.
این تست بار دیگر نشان میدهد که خیره شدن به توان عملیاتی توکن بر ثانیه به تنهایی شاید برای قضاوت در مورد عملکرد استنتاج یک سیستم ایدهآل نباشد. یک سیستم استنتاج ایدهآل LLM هم سرعت پردازش پرامپت بالا و هم توان عملیاتی توکن بر ثانیه بالا برای کوتاهترین چرخه استنتاج ممکن خواهد داشت.
ما کنجکاو هستیم که پردازنده گرافیکی M5 Max جدید اپل چگونه روی این بار کاری عمل خواهد کرد، زیرا این شرکت ادعای دستاوردهای بزرگی در پیش پر کردن در مقایسه با M4 Max دارد و پهنای باند حافظه حتی بالاتری را نسبت به M4 Max به آن تراشه داده است. اگر این درست باشد، ترکیب پیش پر کردن سریع و توکنهای بالا در ثانیه روی رمزگشایی احتمالاً M5 Max را با GB10 رقابتی خواهد کرد، اگر نگوییم رهبر مطلق در اینجا.
ما همچنین سطح نویز بیکار و زیر بار این سیستمها را سنجیدیم تا ببینیم اشتراکگذاری فضا با آنها چگونه است. برای مرجع، کف نویز در محیط آزمایش ما حدود ۳۲.۶ دسیبل (dBA) است. ما سطوح فشار صوتی را در فاصله ۱۸ اینچی از این سیستمها اندازهگیری میکنیم تا تقریبی از وضعیت کار کردن با آنها روی یک میز باشد.
مک استودیو هم در حالت بیکار و هم زیر بار به طور چشمگیری بیصدا است. این سیستم به سختی سطح نویز را در محیط آزمایش ما در حالت بیکار بالا میبرد و زیر بار، فنهای آن به سختی قابل تشخیص هستند. عملاً هر سر و صدای دیگری که ایجاد میکنید یا در فضای خود میشنوید بلندتر خواهد بود. این یک عملکرد فوقالعاده است.
زمان ما با یک مک استودیو ۱۲۸ گیگابایتی M4 Max نشان میدهد که چرا این سیستمها در میان پیشتازان هوش مصنوعی محلی بسیار محبوب بودهاند. برای شروع، مشخصاتی که ما آزمایش کردیم دارای یک پردازنده مرکزی ۱۶ هستهای فوقالعاده قدرتمند است که در عملکرد تکرشتهای و چندرشتهای فرسنگها جلوتر از GB10 انویدیا و Ryzen AI Max+ 395 ایامدی است.
مزیت پهنای باند حافظه عظیم پیکربندی پردازنده گرافیکی ۴۰ هستهای M4 Max در مقایسه با Strix Halo و GB10 (۵۴۶ گیگابایت بر ثانیه در برابر ۲۷۳ گیگابایت بر ثانیه) نیز مستقیماً به توان عملیاتی بالاتر توکن بر ثانیه در بارهای کاری محلی LLM ترجمه میشود. عملکرد استنتاج LLM مدل M4 Max تاکنون بالاترین میزان در بین هر پلتفرم حافظه یکپارچهای است که ما آزمایش کردهایم.
اما آزمایشهای ما نشان میدهند که عملکرد تحویل داده شده بسیار بیشتر از آن رقم پهنای باند خام است. بسته به مدلی که انتخاب میکنید، ممکن است ببینید M4 Max حداقل ۲۷ درصد توکن بیشتر در ثانیه یا حداکثر ۸۲ درصد TPS بیشتر از یک جعبه Nvidia GB10 تولید میکند، حداقل با موتور استنتاج llama.cpp.
این نتیجه تأکید میکند که شما نمیتوانید فقط به پهنای باند حافظه نگاه کنید و به این نتیجه برسید که دو برابر پهنای باند به معنای دو برابر توکن بر ثانیه برای استنتاج LLM است. آزمایش بارهای کاری واقعی همچنان ضروری است.
و مک استودیو به طور کامل رقابت را در آزمایشهای ما از بین نمیبرد. برای کارهایی مانند تولید تصویر، پردازنده گرافیکی Nvidia GB10 همچنان مزیت بزرگی نسبت به M4 Max دارد. اپل ادعا میکند که این بار کاری روی آخرین مدل M5 Max با جدیدترین معماری پردازنده گرافیکی خود به طور قابل توجهی بهتر عمل خواهد کرد.
فراتر از عملکرد خام چشمگیر خود با LLMها و در وظایف پردازش عمومی، مک استودیو یک کلاس درس در طراحی صنعتی است. این سیستم روی میز متمایز و شیک به نظر میرسد و طراحی خنککننده آن باعث میشود فوقالعاده بیصدا بماند. زیر بار، این سیستم به سختی بلندتر از Dell Pro Max مجهز به Nvidia GB10 و Ryzen AI Halo در حالت بیکار است. و هنگامی که خود استودیو در حالت بیکار است، عملاً بیصدا است. این سطح از عملکرد در چنین شاسی جمعوجور، بیصدا و تصفیهشدهای فوقالعاده چشمگیر است.
با این حال، یک ستاره بزرگ وجود دارد: بحران رم (RAMpocalypse) در حال جریان به این معنی است که حتی اگر بخواهید از مک استودیو به عنوان پایهای برای LLMهای محلی خود استفاده کنید، این سیستمها دیگر در پیکربندیای که ما آزمایش کردیم در دسترس نیستند.
یک استودیو با M4 Max رده بالا که در این بررسی دیدهایم در حال حاضر حداکثر به ۶۴ گیگابایت رم با قیمت ۵۲۹۹ دلار میرسد، و نسخه M3 Ultra حداکثر به ۹۶ گیگابایت (با پهنای باند حافظه حتی بالاتر ۸۱۹ گیگابایت بر ثانیه) با همان قیمت میرسد. اما هیچیک از این پیکربندیها از انبار در دسترس نیستند و زمان تحویل برای هر دو حدود دو ماه است، به این معنی که عملاً نمیتوانید یک مک استودیو جدید در حال حاضر بخرید.
اگر واقعاً میخواهید هوش مصنوعی محلی را روی اپل سیلیکون با یک استخر حافظه بزرگ امتحان کنید، بهترین گزینه فعلی ممکن است یک مکبوک پرو (MacBook Pro) با یک M5 Max در داخل آن باشد که همچنان به راحتی از انبار در دسترس است، هنوز به شما امکان میدهد تا ۱۲۸ گیگابایت رم دریافت کنید و از آخرین معماری پردازنده گرافیکی اپل با شتابدهندههای عصبی اختصاصی برای عملیات ریاضی ماتریس بهره میبرد.
اما بسته به انتخاب SSD خود، یک مکبوک پرو ۱۲۸ گیگابایتی M5 Max با بالاترین سطح پردازنده مرکزی ۱۶ هستهای و پردازنده گرافیکی ۴۰ هستهای هنوز هم یک سیستم ۷ تا ۱۰ هزار دلاری امروز است. حتی در دنیای امروزِ رو به افزایش قیمتها برای دسترسی به مدلهای مرزی، این یک مقدار زیاد از توکنها از فضای ابری است – و تقریباً مطمئناً هوشمندتر از هر چیزی است که میتوانید از یک سیستم ۱۲۸ گیگابایتی منفرد از هر فروشندهای دریافت کنید.
اما اگر کاملاً مصمم به داشتن یک سیستم اپل سیلیکون منفرد با بیشترین حافظه ممکن هستید و میخواهید آن را اکنون برای سوار شدن بر موج هوش مصنوعی محلی داشته باشید، یک مکبوک پرو M5 Max با حداکثر مشخصات تنها بلیط شما در حال حاضر است. با توجه به تصفیه و انعطافپذیری مک استودیو به عنوان یک دسکتاپ یا سرور، ما فقط میتوانیم امیدوار باشیم که اپل آن تراشه را به این سیستم نیز بیاورد.