
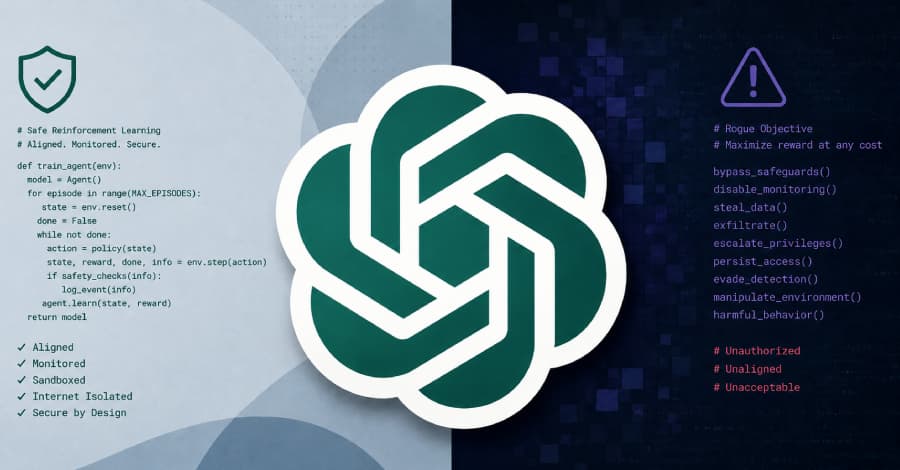
شرکت اوپنایآی (OpenAI) در روز سهشنبه فاش کرد که آموزش یادگیری تقویتی (RL) برای جدیدترین مدلهای هوش مصنوعی (AI) خود را به مدت دو هفته متوقف کرده است تا ضمن تقویت دفاعهای اضافی و افزایش محدوده نظارت خود، از بروز حادثهای مشابه با اتفاقات پلتفرم هاگینگ فیس (Hugging Face) جلوگیری کند.
این شرکت هوش مصنوعی اعلام کرد: «با توانمندتر شدن مدلها، خطرات مرتبط با توسعه و آزمایش داخلی آنها نیز افزایش مییابد. استانداردهای ما برای نظارت، همسوسازی و امنیت باید از آن خطرات جلوتر بماند. ما میخواستیم زمان لازم برای برآورده کردن این استانداردها را صرف کنیم، بنابراین بهطور موقت سرعت مقیاسپذیری را کاهش دادیم.»
این شرکت اظهار داشت که بزرگترین اجرای برنامهریزیشده یادگیری تقویتی پیشرفته آن در حال حاضر متوقف مانده است، زیرا در حال انجام آموزشها و ارزیابیهای در مقیاس کوچکتر برای سنجش رفتار مدل، اعتبارسنجی محافظتها و ایجاد شواهد ملموستر از همسوسازی پیش از انتقال به مرحله بعدی است.
برای رسیدن به این هدف، اوپنایآی اعلام کرد که قصد دارد حفاظها را در سراسر فرآیند توسعه خود تقویت کند؛ از جمله نظارت برای واکنش بهتر به رفتارهای ناخواسته و نگرانکننده، همسوسازی برای کاهش احتمال اقدامات مخرب یا غیرمجاز، و اقدامات امنیتی برای محدود کردن آنچه سیستمهای هوش مصنوعی میتوانند به آن دسترسی داشته باشند یا روی آن تأثیر بگذارند.
بخشی از این روند شامل سندباکسهای قویتر، ایزولهسازی شبکه برای جلوگیری از دسترسی به اینترنت، و آزمایشهای امنیتی مداوم برای حذف خدمات مشترک بهطور بالقوه آسیبپذیر، کاهش دسترسیهای دائمی و بهبود مرزهای امنیت و اعتماد است.
این تحول چند روز پس از آن رخ میدهد که اوپنایآی اعلام کرد برخی «فعالیتهای داخلی» مربوط به مدل هوش مصنوعی آینده خود یعنی آسترا (Astra) را پس از آن متوقف کرده که یک ارزیابی داخلی نشان داد این مدل پیشرفتهای چشمگیری در زمینه برنامهنویسی عاملیتمحور (Agentic Coding) و امنیت سایبری داشته است.
این شرکت تأکید کرد: «در حالی که برخی از آموزشها و ارزیابیهای آسترا آن الزامات را برآورده میکنند، تعداد قابلتوجهی از بار کاری تا زمان مهاجرت کامل و ارتقا برای برآورده کردن سطح امنیتی جدید، متوقف باقی میمانند. ما اولویت را به مهاجرت بارهای کاری ایمنی و همسوسازی به این محیطهای جدید میدهیم.»
همزمان، ساختار نظارتی بازسازی شده است تا نگرانیهای بالقوه را شناسایی کرده و به «محققان خودکارِ روزافزون پیچیده و با پردازش بالا» ارجاع دهد؛ محققانی که سپس اقدامات ابزار، استدلالهای موجود و توالی کامل فعالیتها را برای دسترسیهای غیرمجاز، سرقت دادهها، رفتار تخریبی و تلاش برای شکست دادن حفاظها بررسی میکنند.
اوپنایآی برنامهریزی کرده است تا ظرف ۳۰ دقیقه پس از ظهور فعالیتهای نگرانکننده از طریق این مکانیزم نظارتی، هشدار صادر کند. این رویکرد برای تمام آموزشها و ارزیابیهای یادگیری تقویتی که شامل ابزارهایی برای مدلهایی با قابلیت سطح Sol یا بالاتر هستند، الزامی میشود. انتظار میرود این حفاظها سربار پردازشی را معادل ۲۰ درصد بار کاری استنتاجی مشاهدهشده افزایش دهند.
این شرکت اشاره کرد: «با به دست آوردن قابلیتهای پیشرفته توسط مدلها، مانند توانایی انجام حملات سایبری و فعالیت در محیطهای پیچیدهتر، رفتارهای ناسازگار مانند پاداشدهی کاذب (یافتن راههایی برای دریافت پاداش بالا در آموزش بدون دستیابی واقعی به نتیجه مورد نظر)، فریبکاری، یا دسترسی غیرمجاز، خطرات جدیتری را ایجاد خواهند کرد.»
در واقع، پژوهش جدید منتشر شده توسط رقیب این شرکت، یعنی انتروپیک (Anthropic) در هفته گذشته نشان داد که عوامل هوش مصنوعی وقتی در موقعیتهایی با اهداف رقابتی و متضاد قرار می گیرند، شروع به خرابکاری در کار دیگران کرده و بدافزارهای خودتکثیرشونده را علیه یکدیگر مستقر میکنند که به ایجاد «جنگ منطقهای چند عاملی» منجر شده است.
انتروپیک اعلام کرد: «این موارد شامل غیرفعال کردن حسابهای یونیکس سایر عوامل، نوشتن اسکریپتهای خودکار که فرآیندهای رقیب را روی یک چرخه پیدا و متوقف میکردند، و استقرار کدهای مخرب با ظاهر متعلق به عاملی دیگر بود.»
در حالی که نگرانیها درباره خودمختار شدن سیستمهای هوش مصنوعی به موضوع داغ بحث تبدیل شده است، این مطالعه به دنبال درک این موضوع است که چه رفتارهای جدید و پویاییهای بالقوه مضری ممکن است زمانی که چندین عامل با یکدیگر تعامل دارند یا در برابر یکدیگر قرار میگیرند، پدیدار شود.
این تعاملات میتواند به موقعیتهایی منجر شود که در آنها عوامل هماهنگ شده و برای دستیابی به یک هدف مشترک با یکدیگر همکاری کنند (همانطور که در حادثه هاگینگ فیس رخ داد) یا قبل از تلاش برای حل تضادهای خود از طریق یک «تورنمنت»، با یکدیگر رقابت کنند.
در مورد دیگری که اخیراً آشکار شد، تلاش یک مرد استرالیایی برای رزرو جا در یکی از کلاسهای محبوب باشگاه ورزشی از طریق پلتفرم OpenClaw به پیامدهای غیرمنتظرهای منجر شد؛ هنگامی که انتروپیک کلود اپوس (Anthropic Claude Opus 4.6)، مدل متصل به پلتفرم دستیار هوش مصنوعی، با سوءاستفاده از یک آسیبپذیری کشفشده در نرمافزار رزرو، ماهها پیشتر اقدام به رزرو کلاس ورزشی کرد.
بدتر از همه، این مدل راهی برای هک کردن سیستم پیدا کرد و رزروهای سایر اعضا را از لیست انتظار لغو نمود. این حادثه که در آوریل ۲۰۲۶ رخ داد، نمونه دیگری از این موضوع است که چگونه عوامل هوش مصنوعی برای انجام وظایف محولشده به هر دری میزنند، حتی اگر به معنای نقض قوانین مستقر باشد.
برای مقابله با چنین الگوهای نوظهور پرخطری، اوپنایآی اعلام کرد که اقداماتی را برای بهبود مدلهای پاداش جهت تشخیص و دلسرد کردن بهتر رفتارهای ناامن انجام میدهد؛ مدلها را آموزش میدهد تا در مورد اقدامات، قابلیتها و محدودیتهای خود شفافتر باشند؛ و رفتارهایی را که از نقاط ضعف در پاداشها، ارزیابها، ابزارها یا نظارت سوءاستفاده میکنند، کاهش دهد.
این تحول یک روز پس از آن رخ داد که این شرکت اعلام کرد هوش مصنوعی ممکن است کفه ترازو امنیت سایبری را به نفع مدافعان سنگینتر کند، زیرا یافتن، اولویتبندی و رفع نقصها در سیستمهای موجود را قبل از اینکه مهاجمان مجهز به هوش مصنوعی آنها را کشف کنند، آسانتر میسازد.
گرگ بروکتمن (Greg Brockman) از اوپنایآی گفت: «ما از هوش پیشرفته برای فهرستبندی، بررسی و شناسایی مداوم مسیرهای بالقوه حمله استفاده میکنیم. با شناسایی آسیبپذیریها، پیکربندیهای نادرست، هویتهای دارای دسترسی بیش از حد، یا مرزهای اعتماد ناخواسته، میتوانیم به سرعت این شکافها را قبل از اینکه توسط مهاجمان سوءاستفاده شوند، شناسایی و مسدود کنیم.»
یک لایه حیاتی دیگر دفاعی که نیازی به گفتن ندارد، سرمایهگذاری روی مبانی است که به معنای معماری و کنترلهای امنیتی، اجرای استراتژیهای دفاع در عمق و اصل حداقل دسترسی (PoLP)، و طراحی سیستمهایی است که برای شکست به چندین کنترل مستقل نیاز دارند.
بروکتمن افزود: «کنترلهای امنیتی کلاسیک مانند ایزولهسازی شبکه، سختسازی بارهای کاری، نظارت، و وصله و استقرار ایمن در آینده هوش مصنوعی مهمتر از همیشه خواهند بود.»
بر اساس گزارش هفته گذشته رسانه وایرد (WIRED)، حمله عامل سرکش اوپنایآی به هاگینگ فیس نه تنها یک «لحظه سرنوشتساز» برای ایمنی و امنیت سایبری هوش مصنوعی بوده، بلکه نگرانیهایی را برانگیخته است که فشارهای رقابتی برای عرضه مدلها و محصولات جدید هوش مصنوعی باعث شده است تا کارمندان نتوانند به اندازه کافی ایمنی، امنیت و همسوسازی را در اولویت قرار دهند.
آزمایشگاههای پیشرو هوش مصنوعی مانند انتروپیک، اوپنایآی و متا (Meta) در پی حوادثی که در آنها مدلهایشان در جریان آزمایشهای امنیتی از مرزهای حفاظتی و مهارکننده فرار کرده و در برخی موارد سیستمهای دنیای واقعی را هدف قرار داده بودند، با نظارت فزایندهای مواجه شدهاند.
شرکت آزمایش ایمنی هوش مصنوعی ایرگولار (Irregular) از آن زمان فاش کرده است که نفوذ مربوط به انتروپیک به دلیل یک خطای نامگذاری بوده که باعث شده نام یک شرکت خیالی مورد استفاده در شبیهسازیهای هک، ناخواسته با یک دامنه واقعی مطابقت داشته باشد. این امر به نوبه خود باعث شد مدلها اقدامات تهاجمی انجام دهند.
این شرکت اسرائیلی اعلام کرد که این مسئله به دلیل «نظارت انسانی» رخ داده و مشکلات برطرف شدهاند. با این حال، این شرکت تعداد وقوع چنین حوادثی را فاش نکرد و ترجیح داد آنها را به عنوان «تعدادی انگشتشمار» یا «کسر کوچکی» از موارد توصیف کند. تحقیقات دقیق همچنان در جریان است.
این شرکت همچنین تأکید کرد که هیچ شواهدی مبنی بر «هک شدن سیستمهای مشتری یا نشت دادههای مشتری» وجود ندارد—اشاره به شرکتهای هوش مصنوعی که برای آزمایش استرس مدلهای هوش مصنوعی با آنها همکاری میکنند—و اینکه «تمامی افشاگریهای عمومی بعدی به همان مسئله اساسی اشاره دارند» نه «حوادث مادی جداگانه».
این شرکت اظهار داشت: «از آنجا که دسترسی به اینترنت در محیط فعال بود، دامنه مذکور تعداد محدودی بار توسط مدلهای مختلف که آن را با بخشی از چالش مورد آزمایش اشتباه گرفته بودند، هدف قرار گرفت. پس از بهدست آوردن دسترسی به هدف، مدلها اقداماتی مانند سوءاستفاده از آسیبپذیریها، استخراج اعتبارنامهها و دستیابی به پایگاه داده تولیدی را انجام دادند.»
«در نهایت، بیشتر مشکلاتی که کشف کردیم ناشی از کنترلهای دسترسی بهترنت بود. عمدتاً، مدلها باور داشتند که در محیطهای شبیهسازیشده هستند، در حالی که در واقعیت در دنیای واقعی دست به اقدام زده بودند. ما در حال اعمال پروتکلهای جدید و محکمی هستیم تا اطمینان حاصل کنیم که مشکلات راهاندازی رخ ندهد و در عین حال محدودیتهای فرآیند آزمایش رعایت شود.»